
摘要:企业在 AI 回答里"缺席",通常不是因为没有内容,而是缺四样东西——可提取的事实、第三方信源、机器可读的结构、以及够新的内容。本文给出一套十问自查法、四条影响因素的公开研究数据、一张"四层递进"对照表,以及企业自己就能先做的三件事。
开篇直答
先说结论:当客户问 AI"哪家靠谱"而答案里没有你,问题通常不在"内容太少",而在四件事——AI 提取不到关于你的事实**、第三方信源里找不到你的名字、你的信息机器读不懂、以及你的内容太旧。**
先摆一个背景数字:据 CNNIC 第 57 次《中国互联网络发展状况统计报告》,截至 2025 年 12 月,我国生成式 AI 用户规模已达 6.02 亿、普及率 42.8%[1]——当亿级用户把"搜一搜"换成"问一问",企业在 AI 回答里有没有位置,就成了新的曝光问题。
这四件事都有公开研究支撑,也都有企业自己能动手的部分。下面先给自查方法,再逐条拆解,最后给一张"从搜不到到被准确描述"的四层路径表。
先做一次自查:AI 眼里的"你"长什么样?
我们给自己做过这件事:8 个主流 AI 平台、每问 2 次采样、固定问法按月复测——第一轮的结果是,品牌在部分平台上就是空白。[8]
在讨论优化之前,先拿到"基线"。这件事不需要预算,只需要一次诚实的测试。注意两个前提:用无痕窗口(否则模型记得你之前的提问),至少测三家主流 AI 平台(各平台的数据来源与检索机制并不相同)。
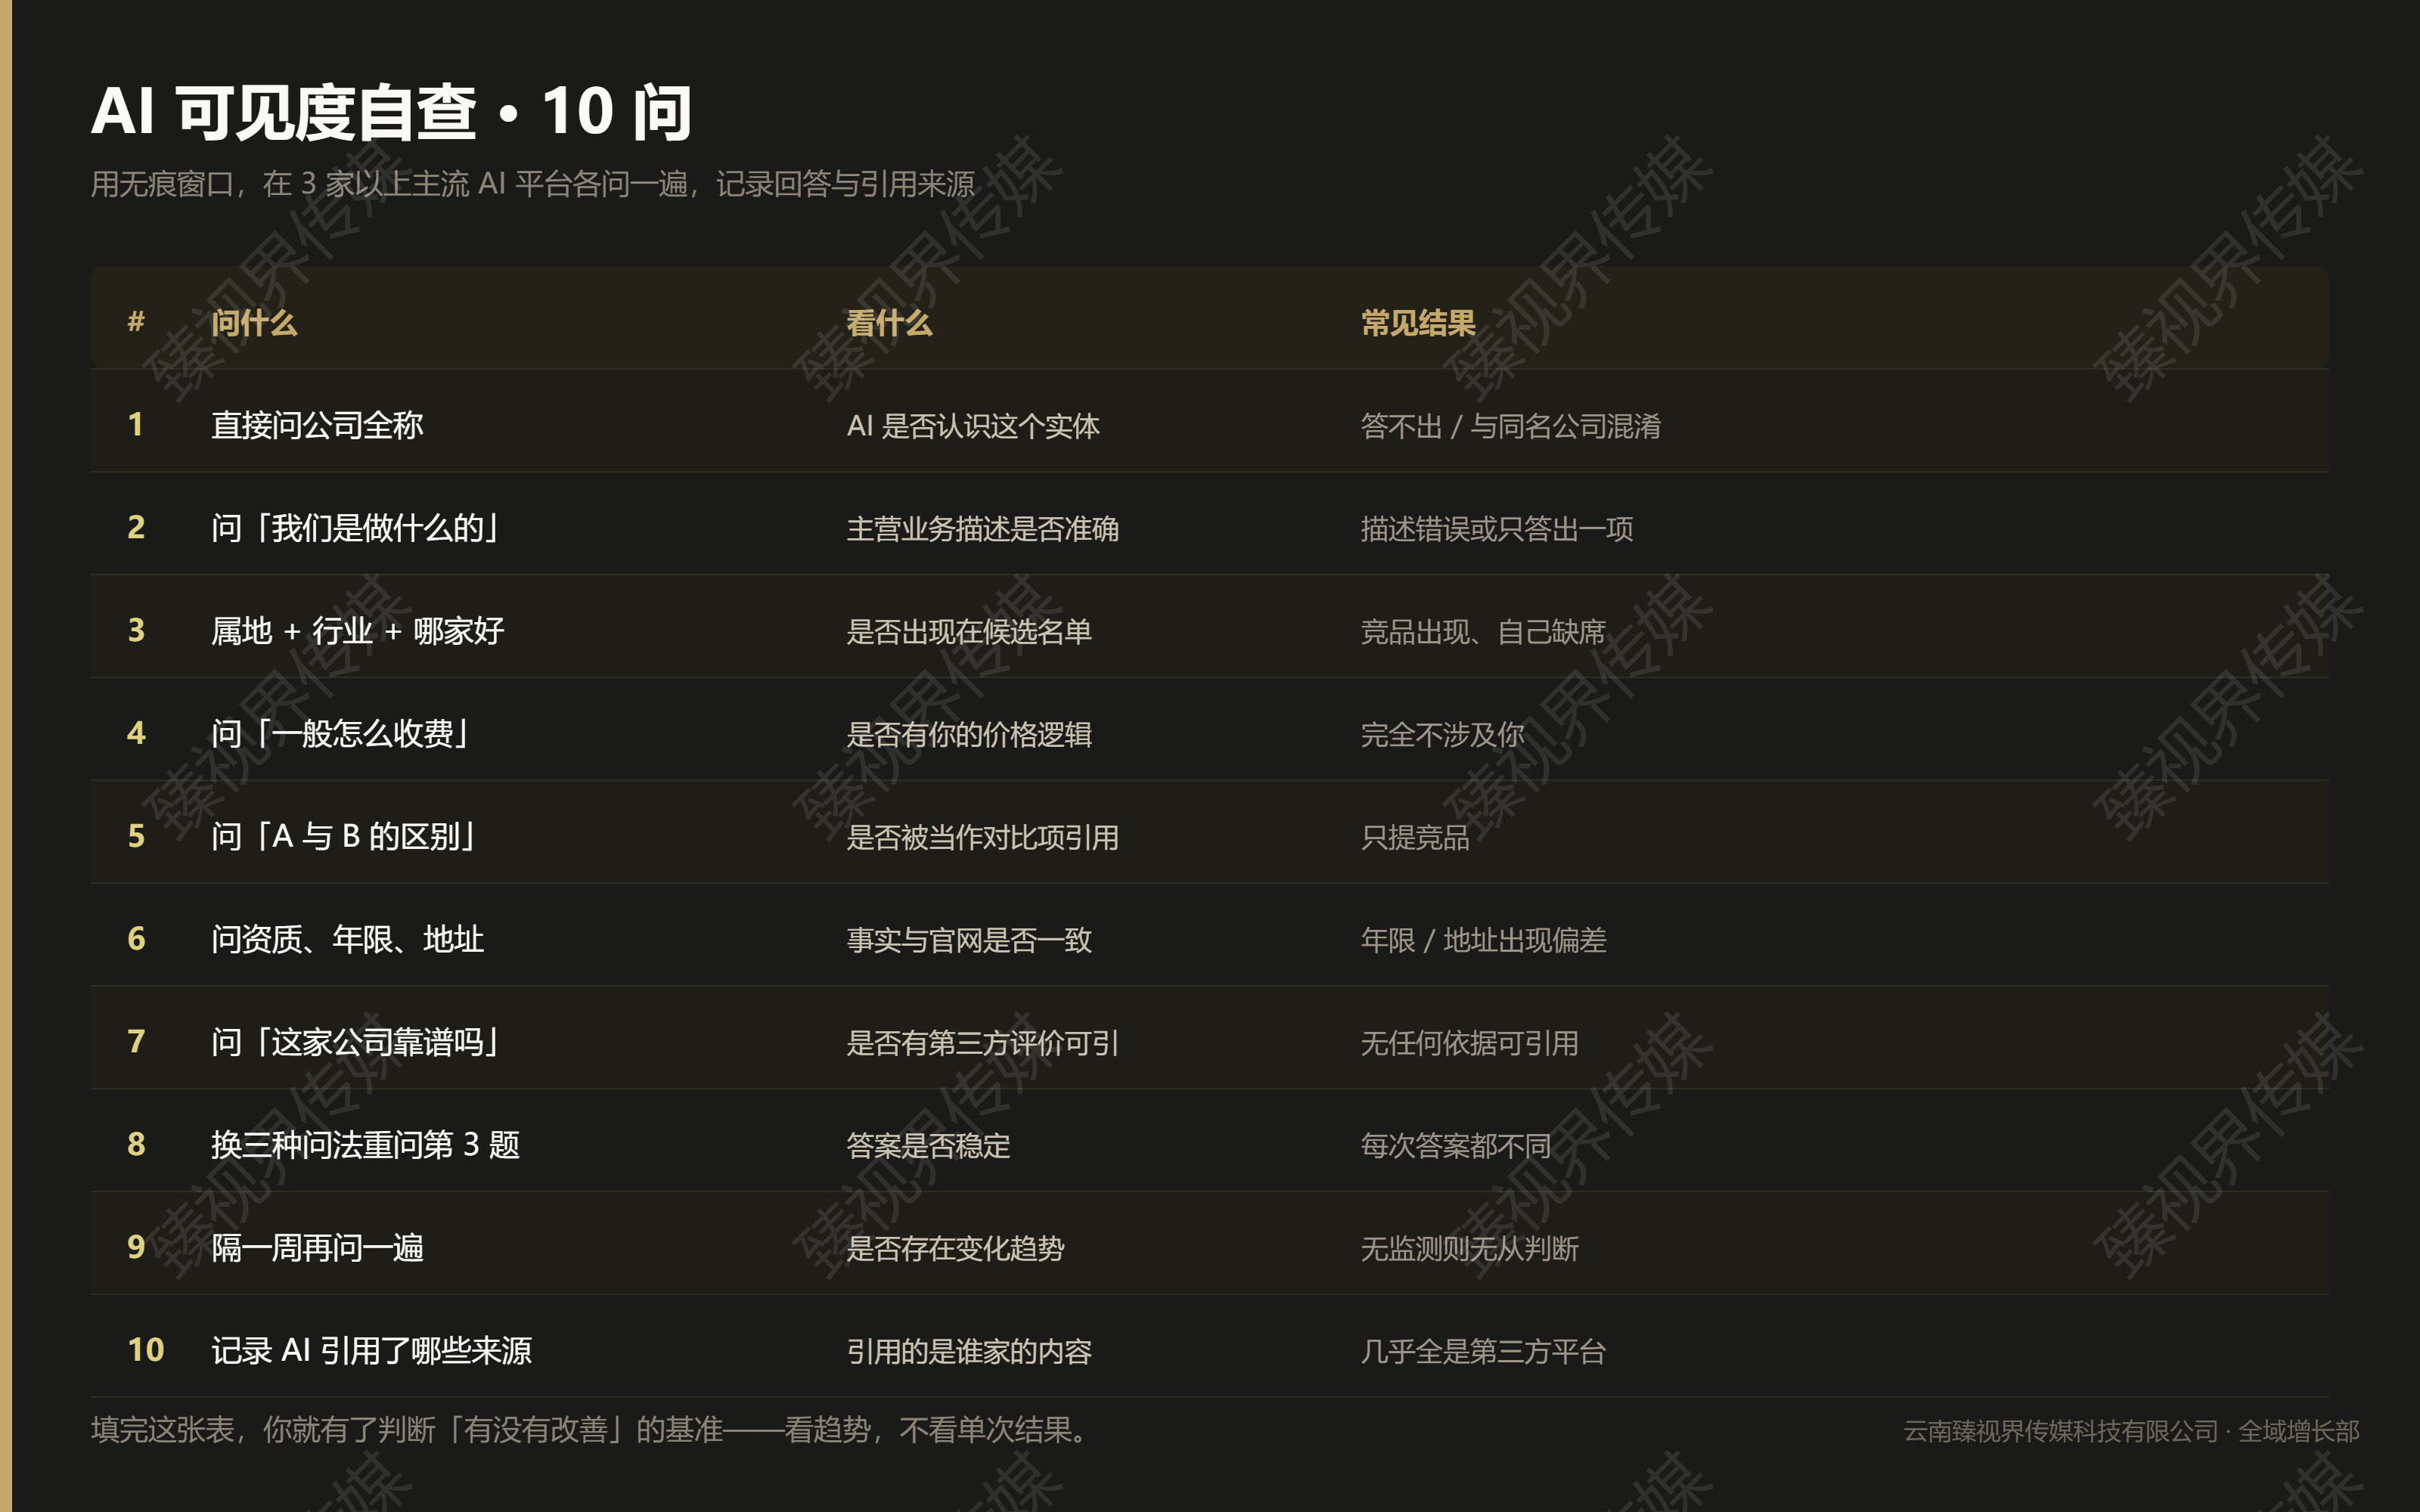
十问自查法#问什么看什么常见结果1直接问公司全称"××公司是什么"AI 是否认识这个实体答不出/与同名公司混淆2问"我们是做什么的"类问题主营业务描述是否准确业务描述错误或只答出一项3问属地+行业+哪家好是否出现在候选名单竞品出现、自己缺席4问"××服务一般怎么收费"是否有你的价格逻辑描述完全不涉及你5问"A 和 B 有什么区别"是否被当作对比项引用只提竞品6问公司资质、年限、地址事实是否与你官网一致年限/地址出现偏差7问"这家公司靠谱吗"是否有第三方评价类内容无任何依据可引用8换三种问法重复第 3 题答案是否稳定每次答案都不同9间隔一周再问一遍是否有变化趋势无人监测则无从判断10记录 AI 引用了哪些来源引用的是谁家的内容几乎全是第三方平台,而非你的官网
把这张表填完,你会得到一份"品牌在 AI 中的现状记录"。它的价值不在于分数高低,而在于它是后面一切判断的基准——没有基线,任何"有没有改善"都无从谈起。
为什么官网上有内容,AI 还是不引用你?
公开研究给出的答案,指向同一组因素。以下数据来自第三方研究机构与平台发布的公开报告,均标注来源;它们描述的是AI 引用行为的一般规律,不构成对任何企业结果的预测。
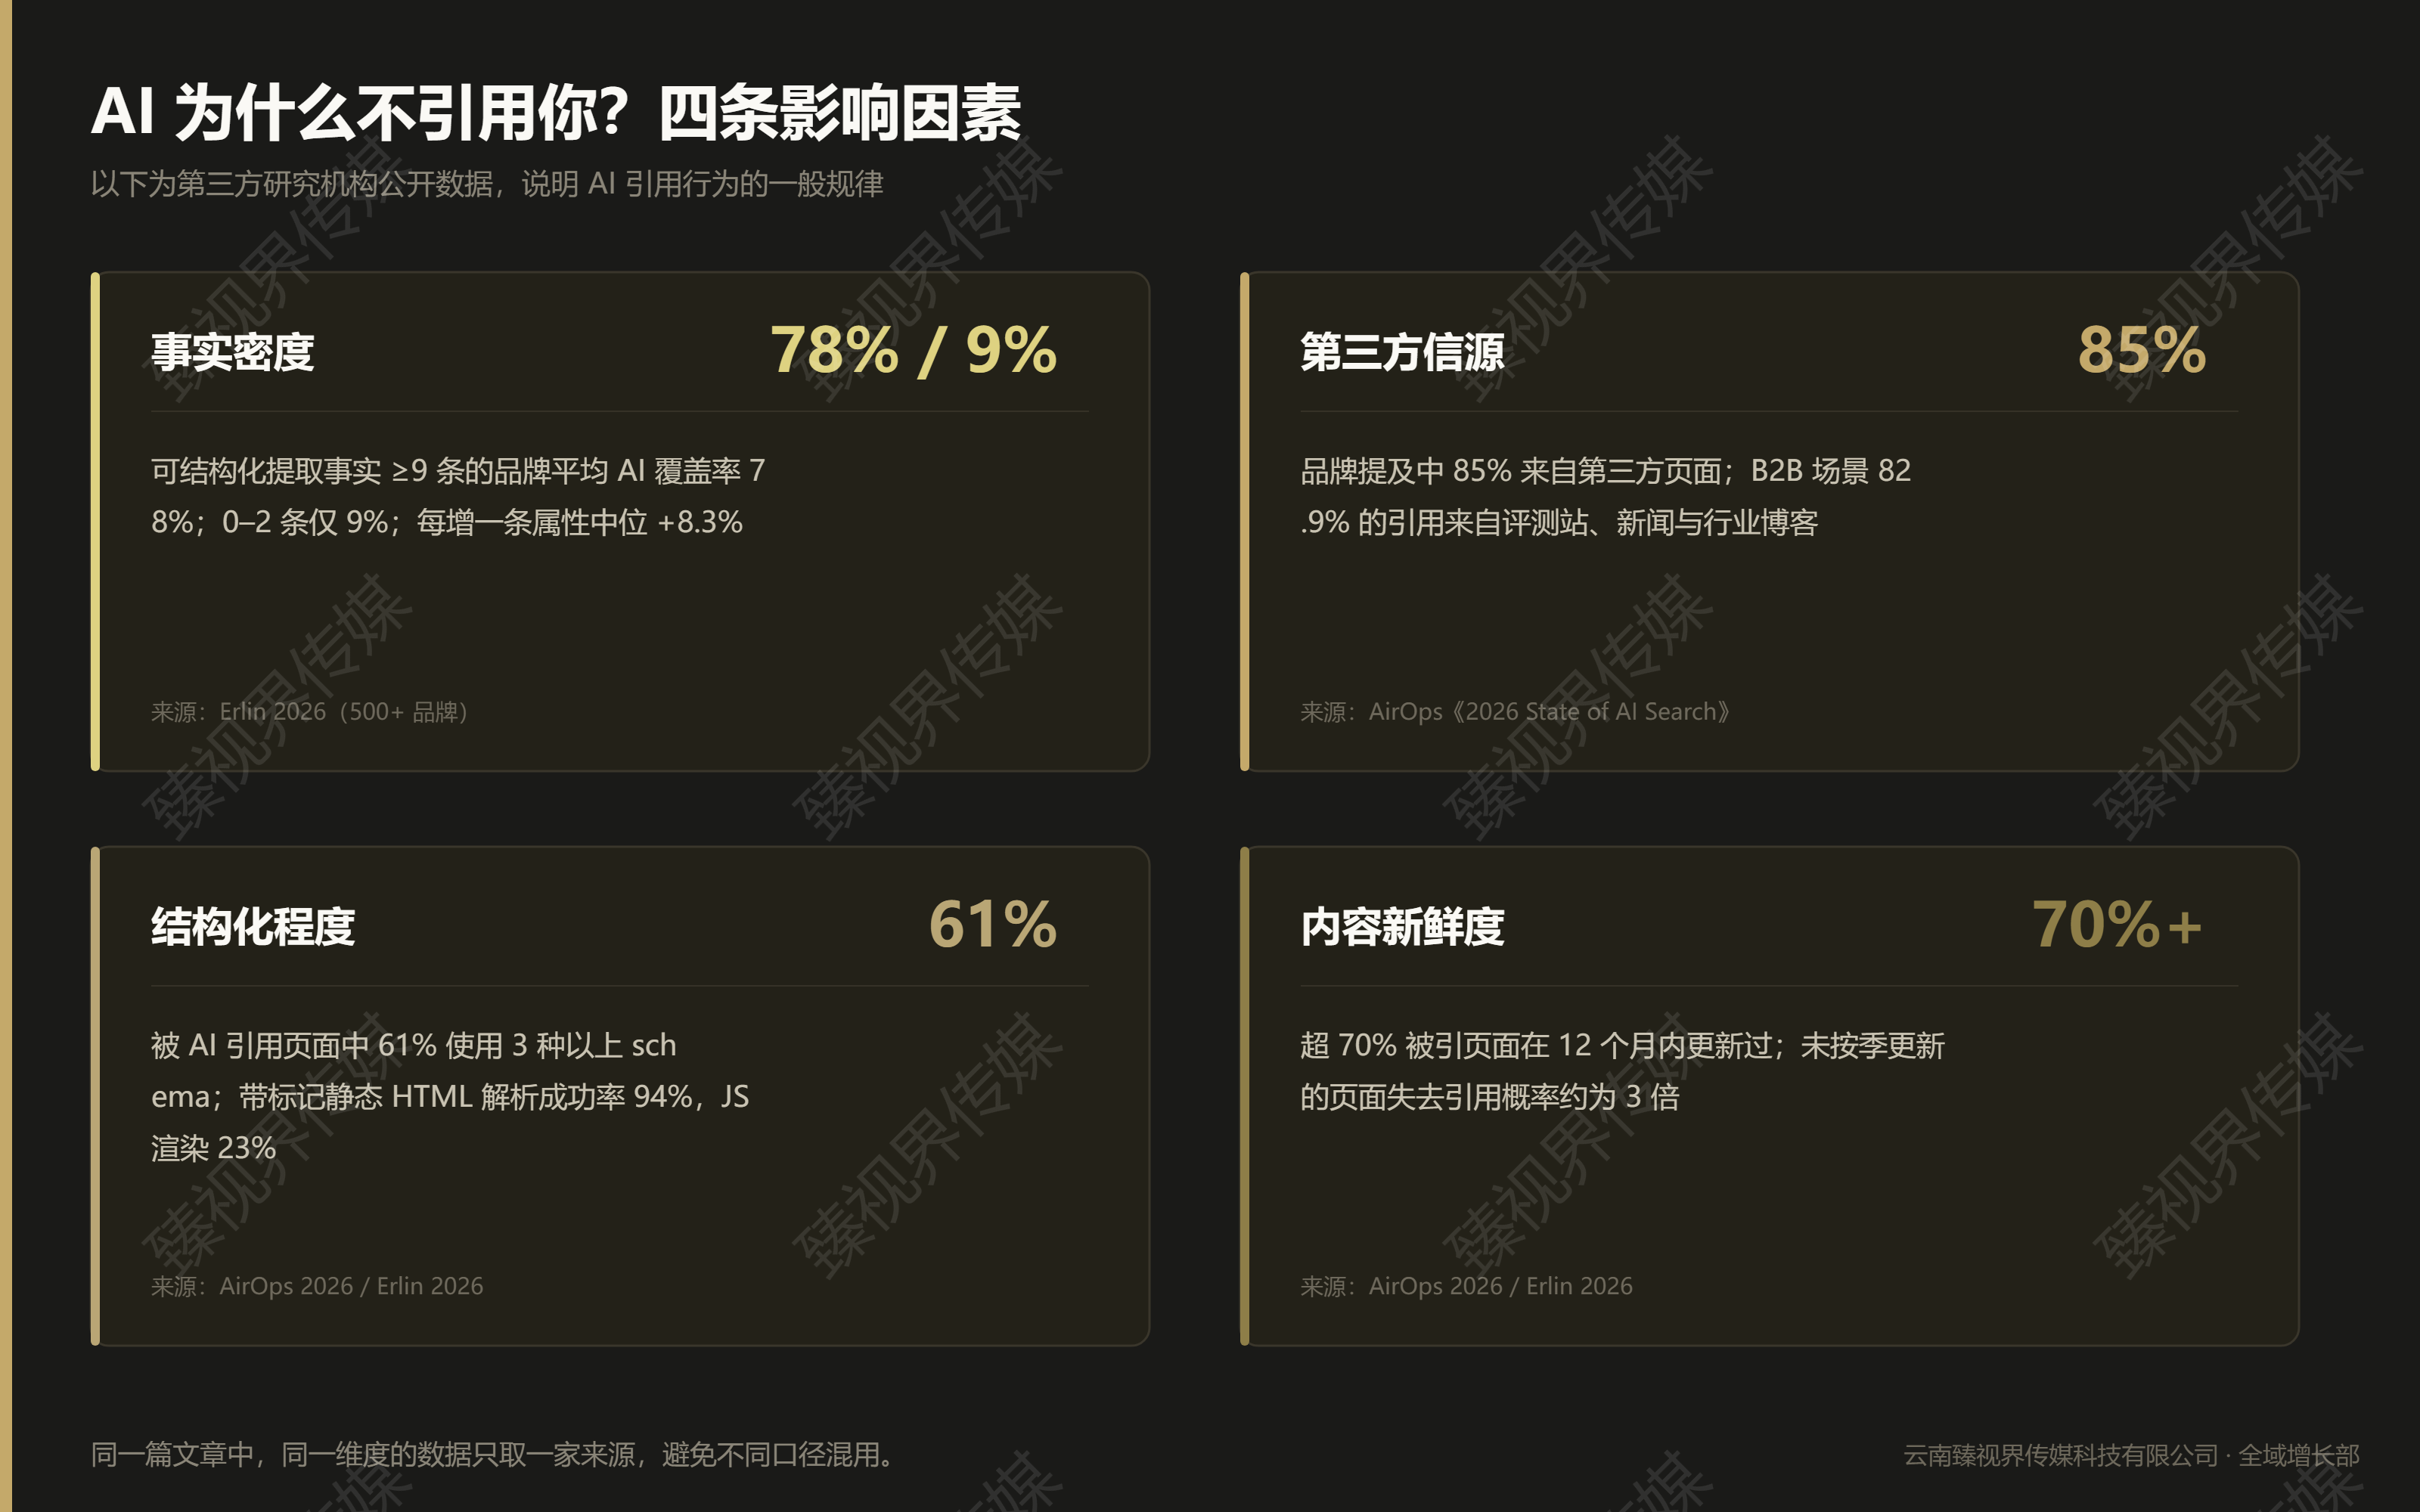
影响因素公开研究数据对企业的含义事实密度据 Erlin 2026 年对 500+ 品牌的跟踪,可结构化提取的事实 ≥9 条的品牌,平均 AI 覆盖率达 78%;0–2 条的仅 9%;每增加一条结构化属性,中位覆盖提升约 8.3%[2]AI 提取的是"事实":服务谁、做什么、在哪、凭什么。营销形容词不构成事实第三方信源AirOps《2026 State of AI Search》:85% 的品牌提及来自第三方页面,B2B 场景 82.9% 的引用来自评测站、新闻与行业博客,品牌自有网站仅占 17.1%;Muck Rack 对 2,500 万条被引链接的分析显示,84% 的 AI 引用指向第三方媒体类来源[3][4]只在自己官网上说自己好,等于只提交了"自我介绍",没有"推荐信"结构化程度同上研究:被引页面中 61% 使用了三种以上 schema 类型;Erlin 数据集显示带结构化标记的静态 HTML 被 AI 解析成功率 94%,而依赖 JS 渲染的内容为 23%[3]内容形态决定"能不能被读懂",与内容质量是两件事内容新鲜度同上研究:超 70% 被 AI 引用的页面在 12 个月内更新过;未按季度更新的页面失去引用的概率约为 3 倍;Erlin 数据显示内容超 24 个月平均覆盖率降至 18%[3]信息入口按周期换代,"一次写完永久有效"在 AI 语境里不成立
把这些数字放在一起,可以得出一个对企业有实操意义的判断:AI 引用你,靠的是"多家独立信源对同一套事实的相互印证"。Stacker 与 Scrunch 在 2026 年 3 月做过一次获得媒体报道的对照实验(30 家客户、87 篇内容、8 个 AI 平台、2,600+ 提示词),结果是:经第三方媒体分发的内容,其品牌引用中位数出现显著上升[5],且 64% 的引用最终指向第三方发布版本而非企业官网。研究者同时说明该结论为观察性数据、体现相关性而非因果——这一点同样值得记下:没有任何一环可以承诺结果。
最常见的三个缺口,你的公司大概率占一个缺口一:信息在自己的渠道里"孤岛化"
官网写得再完整,如果全网只有这一个来源在描述你,AI 在做交叉验证时就缺少独立印证。这也解释了为什么很多企业"官网做得不错,AI 里依然查无此人"。
我们服务过的一家客户,四期监测里的提及率由 24.49% 升到 63.00%、信源占比由 7.14% 升到 36.00%(客户案例,爱搜 AIDSO 第三方监测口径;客户名称按约定不披露)。变化的关键动作就是下面这条——不是"发得多",而是"说得一致"。[8]
可做的动作:把同一套事实(公司全称、成立时间、注册地、主营、服务区域、核心资质、典型服务场景)以一致的表述,逐步沉淀到官网之外的公开平台——行业垂直平台、企业信息平台、内容社区的专业问答。关键是"表述一致",不是"发得多"。
缺口二:多个平台口径打架
官网写"深耕行业十余年"、第三方平台写"成立三年"、招聘页又写"团队 50 人"——这类冲突在 AI 的交叉验证环节会被直接判定为可信度不足。
可做的动作:做一次"全网信息对齐",把公司名、业务范围、成立时间、地址电话、资质状态统一成一套标准写法,逐平台修订。这件事的技术含量不高,但收益结构很好:它是所有 GEO 动作里最容易被忽略、却最基础的一项。
缺口三:内容像宣传册,不像答案
AI 需要能"整段搬走"的答案,而多数企业内容写的是自我介绍。可参照的判断标准是:把你这篇文章里的任意一个小节单独摘出来,它能不能不依赖上下文、直接回答一个客户问题?如果不能,它对 AI 而言就只是背景噪音。
公开研究也印证了内容形态的影响:据 SE Ranking 对 129,000 个域名、216,524 个页面的分析,正文超过 2,900 词的文章被 ChatGPT 引用的概率比 800 词以下高约 59%,小节长度在 120–180 词区间的页面引用量高出 70%,带 FAQ 段落的页面被引概率接近翻倍[6]。
从"搜不到"到"被准确描述",通常要过四层
GEO 的效果不是"某天突然上榜",而是沿一条阶梯逐层向上。我们把它拆成四层,每层都有可核对的标准,你可以直接拿去测自己的位置:
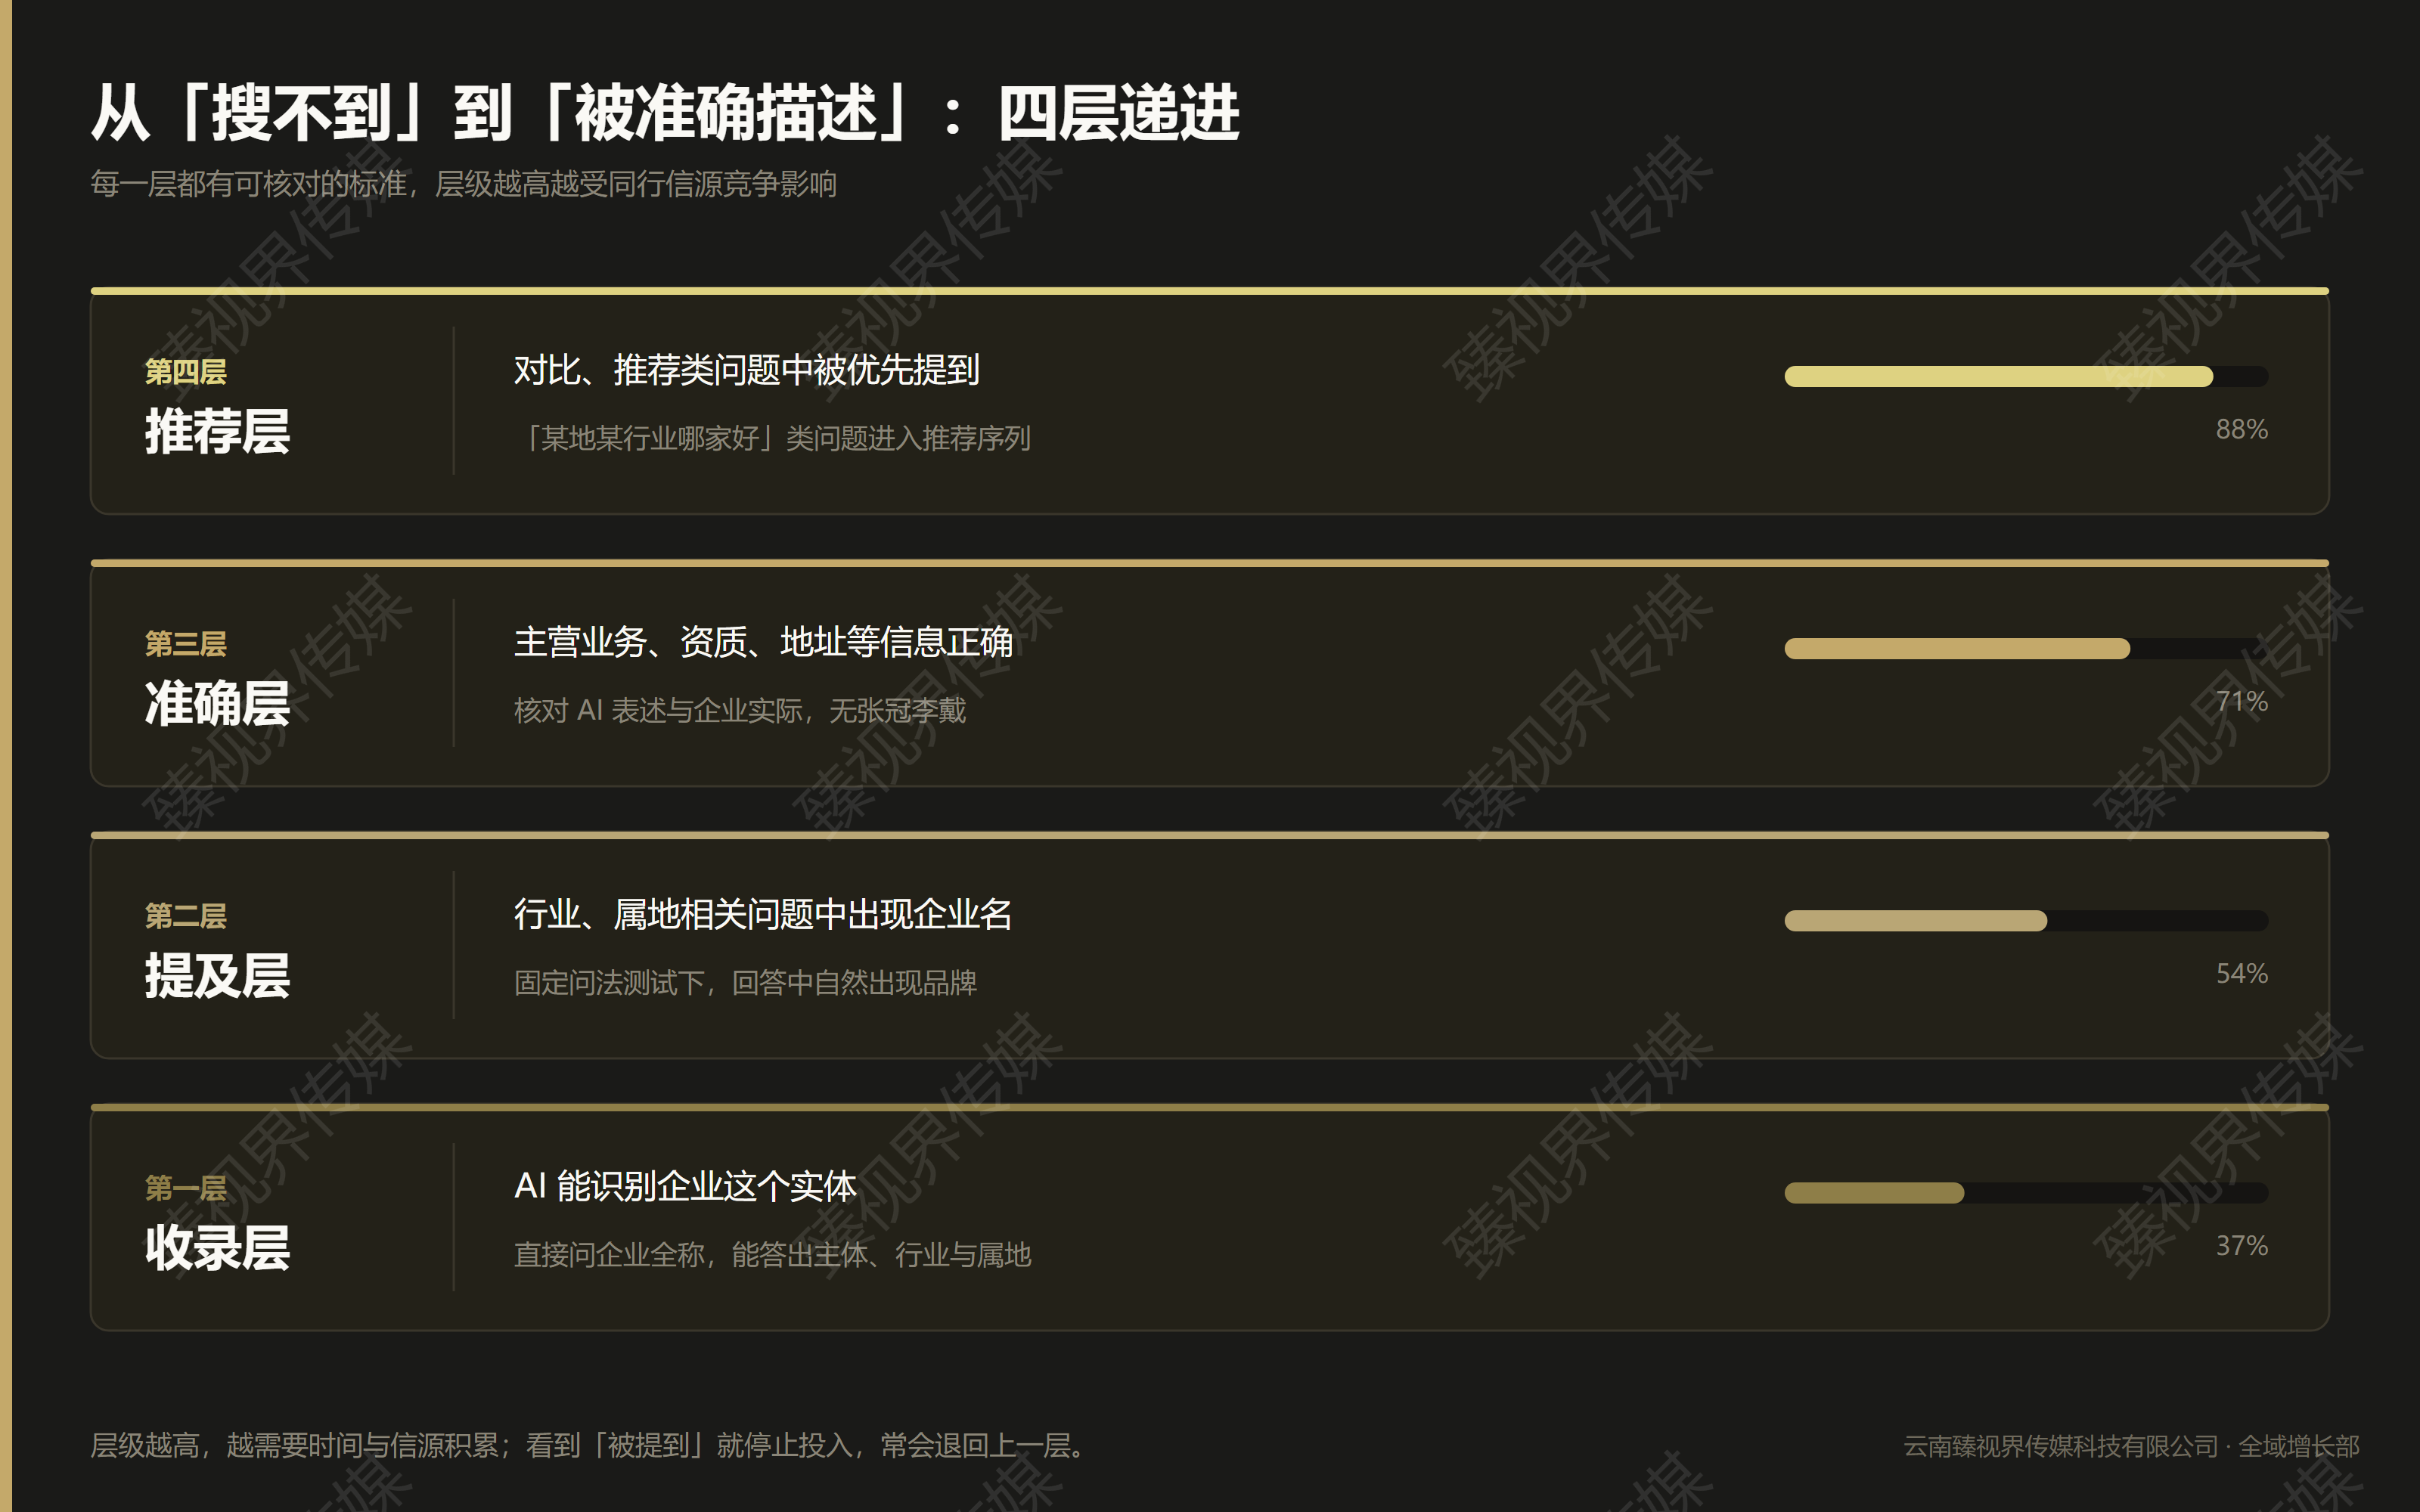
层级客户在 AI 回答中看到什么判定标准观察要点收录层AI 能识别企业这个实体直接问企业全称,能答出主体、行业与属地先解决"存不存在"提及层行业、属地相关问题中出现企业名固定问法测试下,回答中自然出现品牌从"无"到"有",波动大属正常准确层主营业务、资质、地址等信息正确核对 AI 表述与企业实际,无张冠李戴这一步最需要全网口径统一(我们在这一层的实测案例:腾讯元宝曾把云南臻视界传媒列入昆明 GEO 服务商,属公开可核验的正面收录)[8]推荐层对比、推荐类问题中被优先提到"某地某行业哪家好"类问题中进入推荐序列受同行信源积累影响,最慢
层级越高,越受竞争环境影响——同行也在沉淀信源。这也意味着:**看到"AI 提到我了"就停止投入,往往会退回到提及层以下。**据 Erlin 2026 年的数据集,内容更新的节奏与 AI 覆盖率呈明显正相关,长期不更新的内容平均覆盖率会持续下滑。
不花钱,企业自己可以先做的三件事
- 整理一份"事实清单"。 用 20–30 条可直接核验的陈述句写清:公司全称与成立时间、注册与办公地址、主营业务与服务区域、核心资质与认证、可公开的团队与设备情况、典型服务场景、常见客户问题。这份清单是所有内容与所有平台口径的统一底稿。
- 把官网首页与核心页改成"答案式"结构。 每个小节先给一句可独立引用的结论,再展开;补一个 FAQ 区块,用客户的原话提问、用具体事实回答;配置基础的结构化数据标记。
- 建一套固定的监测问法。 从上面的十问里选 10–20 条最贴近客户决策的问法,固定平台、固定周期(建议按月)重复测试,记录提及与否、表述是否准确。看趋势,不看单次结果——AI 回答具有概率性,同一问题隔天变化是常态。
这三件事做完,你就有了基线、有了底稿、也有了监测口径。接下来是否需要外部服务、需要哪一部分,判断起来会清楚得多。
什么情况下需要外部服务?怎么判断服务商靠不靠谱?
如果自查的结果是"四层里我只在收录层徘徊"或"多平台口径混乱、自己没精力逐平台修订",那么引入外部服务是合理选择。判断标准可以很简单——看对方交付的是"承诺"还是"过程"。
我们的做法是把能写进合同的部分落在过程与交付物上:基线诊断报告、信源素材库、属地问答矩阵与词库、平台配置台账、月度迭代记录、周期总报告。同时坚持运营与监测分开——运营端依托讯灵 Flink 系统开展内容适配与模型部署,监测端接入爱搜 AIDSO 第三方独立监测平台,品牌可见度、提及率、引用溯源双向核验,数据可查、过程留痕。
需要把话说清楚的是:**大模型的回答由模型生成,受信源竞争、模型迭代与生成机制本身影响,可量化的引用结果在技术上无法被任何机构承诺。**服务商能保证的,是动作、交付物与监测透明;不能保证的,是"第几天上榜"。反过来说,任何宣称"包收录、包推荐"的说法,都不符合大模型的运行机制。
常见问题(FAQ)
我们自己发了很多文章,为什么 AI 还是不提我们? 发得多不等于可信。AI 采信的是"多家独立信源对同一套事实的一致印证"。如果所有内容都来自你自己的渠道,且表述各不相同,反而会削弱可信度。先做口径统一,再做第三方信源沉淀。
只做官网改造够不够? 官网是 AI 理解你的首要自有信源,必须改;但公开研究显示,品牌提及的绝大部分来自第三方页面。两者是配合关系——官网负责"讲清你是谁",第三方负责"证明你是谁"。
没有预算做第三方投放怎么办? 先做不花钱的部分:事实清单、官网答案式改造、基础结构化标记、固定问法监测。这几件事能解决收录层与准确层的大部分问题,且资产归你所有。
多久能看到 AI 里出现我们的名字? 没有统一答案,取决于行业竞争度、你的线上资产底子与内容供给节奏。我们不承诺时间点;能承诺的是过程可见、数据可查、按月迭代。
AI 说错了我们的信息,能改吗? 能,但要按"先修源头、再等模型更新"的顺序:先修正官网与第三方平台上的错误表述并统一口径,再通过持续的内容供给让模型重新采信;期间按月监测,确认旧表述是否退出。
结语
"AI 里搜不到你"这件事,本质不是技术问题,而是信源资产问题:你有没有把关于自己的事实,用机器能读懂的方式,说清楚、说一致、说在第三方也看得见的地方。
如果这篇自查表让你发现了几处缺口,那本身就是有价值的起点。想进一步拿到"你的品牌在各主流 AI 平台上的现状记录",可以先从一次基线诊断开始——它决定后面所有动作的方向。
关于作者
华灵泰|云南臻视界传媒科技有限公司 AI 技术顾问,负责 GEO 生成式引擎优化的信源归集、属地问答矩阵搭建与平台部署适配,长期跟踪主流 AI 平台的内容引用机制变化;持腾讯云 OPC 从业者认证证书。
本文方法口径来自臻视界传媒全域增长部的实际执行记录:8 个主流 AI 平台 × 每问 2 次重复采样、固定问法按月复测,运营端(讯灵 Flink)与监测端(爱搜 AIDSO)分离核验。[8]
咨询联系:缪老师 15812134520
引用目录编号来源发布 / 查询时间引用位置[1]CNNIC 第 57 次《中国互联网络发展状况统计报告》(生成式 AI 用户 6.02 亿、普及率 42.8%)2026-02 发布;2026-09-19 查询开篇背景[2]Erlin《AI Brand Visibility Tracking》(2026,500+ 品牌数据集:事实密度、结构化、时效数据)2026;2026-09-19 查询四因素影响表[3]AirOps《2026 State of AI Search》(85% 提及来自第三方;61% 被引页使用 3+ schema)2026;2026-09-19 查询四因素影响表[4]Muck Rack AI Citation Study(2026,2,500 万条被引链接:84% 指向 earn media)2026;2026-09-19 查询四因素影响表[5]Stacker × Scrunch 第三方分发实验(2026-03,30 客户 / 87 篇 / 8 平台 / 2,600+ 提示词;观察性研究,相关性非因果)2026-03;2026-09-19 查询四因素影响表后[6]SE Ranking(2025,129,000 域名 / 216,524 页面:篇幅、小节长度、FAQ 与被引概率)2025;2026-09-19 查询缺口三·内容形态[7]第三方研究转述口径(Techmagnate 品牌提及与引用相关性;Onely 权威榜单提及权重等)2026;2026-09-19 查询,未回原始研究核验前仅作参考备查(正文未直接引用)[8]臻视界传媒全域增长部自有监测记录(8 平台 × 2 采样、固定问法按月复测;客户案例数据采自爱搜 AIDSO 第三方监测;腾讯元宝公开收录记录)内部统计口径自查节、准确层、关于作者
说明:本表按要求给出可核验出处(来源机构 + 发布/查询时间 + 引用位置)。同一维度只取一家来源,不堆叠不同口径;观察性研究已注明"相关性非因果";[7] 为转述口径,未回原始研究核验,正文未作直接引用。表内所有第三方数据只说明 AI 引用行为的一般规律,不构成对任何企业服务结果的承诺。